

Ausfälle zählen zu den größten Herausforderungen beim Betrieb moderner IT-Infrastrukturen. Ein Server reagiert nicht mehr, ein Container stürzt ab, eine Anwendung verliert die Verbindung zu einer Datenbank oder ein Dienst benötigt plötzlich deutlich mehr Ressourcen als erwartet. In klassischen Infrastrukturen bedeutet das in der Regel: Problem erkennen, Ursache analysieren, manuell eingreifen und anschließend prüfen, ob das System wieder funktioniert. In modernen Cloud-Umgebungen kann ein Teil dieser Prozesse automatisiert ablaufen.
Self-Healing-Systeme erkennen bestimmte Fehlerzustände selbstständig und leiten automatisch Maßnahmen zur Wiederherstellung ein. Dadurch können Anwendungen und Infrastrukturkomponenten auch dann stabil betrieben werden, wenn einzelne Komponenten ausfallen. Besonders im Zusammenspiel mit Managed Cloud Services, Kubernetes, Monitoring und Automatisierung entfaltet Self-Healing sein Potenzial. Anstatt bei jedem Problem einen manuellen Eingriff zu benötigen, kann die Plattform auf definierte Zustände reagieren und beispielsweise einen fehlerhaften Container neu starten, einen Workload auf einen anderen Node verschieben oder zusätzliche Ressourcen bereitstellen.
Was bedeutet Self-Healing in der Cloud?
Der Begriff „Self-Healing” bezeichnet die Fähigkeit eines IT-Systems, Fehler oder Abweichungen automatisch zu erkennen und geeignete Maßnahmen einzuleiten, um einen definierten Betriebszustand wiederherzustellen.
Das Prinzip lässt sich wie folgt darstellen:
Abweichung erkennen → Zustand bewerten → Gegenmaßnahme ausführen → Zustand überprüfen.
Ein einfaches Beispiel: Ein Container stellt eine Webanwendung bereit. Aus unbekannten Gründen beendet sich der darin laufende Prozess. Ohne Self-Healing bleibt die Anwendung so lange nicht erreichbar, bis der Container manuell neu gestartet wird. Mit Self-Healing kann eine orchestrierende Plattform hingegen erkennen, dass der Container nicht mehr dem gewünschten Zustand entspricht. Sie startet ihn automatisch neu. Anschließend wird überprüft, ob die Anwendung wieder korrekt funktioniert.
Der entscheidende Punkt dabei ist: Self-Healing bedeutet nicht, dass eine Cloud jedes technische Problem vollständig selbst lösen kann. Vielmehr bedeutet es, dass bekannte und automatisierbare Fehlerzustände ohne manuellen Eingriff behandelt werden können. Damit ist Self-Healing ein wichtiger Bestandteil moderner Cloud-Automatisierung und Ausfallsicherheit.
Warum sind Self-Healing-Systeme wichtig?
Moderne Anwendungen bestehen zunehmend aus zahlreichen miteinander verbundenen Komponenten. Microservices, Container, APIs, Datenbanken, Message Queues und weitere Services bilden gemeinsam eine Anwendung. Je komplexer eine Umgebung wird, desto schwieriger wird es, jeden einzelnen Fehler manuell zu beheben. Gleichzeitig laufen Cloud-Anwendungen häufig rund um die Uhr. Ein Ausfall um drei Uhr morgens ist genauso kritisch wie ein Problem während der normalen Arbeitszeit.
Self-Healing kann hier mehrere Vorteile bieten:
- Schnellere Reaktion auf Fehler
- Weniger manuelle Eingriffe
- Höhere Verfügbarkeit
- Reduzierung von Ausfallzeiten
- Entlastung von IT-Teams
- Automatisierbare Standardprozesse
- Bessere Skalierbarkeit des Betriebs
- Konstantere Reaktionen auf wiederkehrende Fehler
Das ist besonders bei Managed Cloud Services interessant: Je mehr standardisierte Betriebsaufgaben automatisiert werden können, desto stärker können sich IT-Teams auf komplexe Aufgaben und die Weiterentwicklung ihrer Anwendungen konzentrieren.
Der NWS Newsletter
Neue Produkte, frische Features und Termine für Events und Talks: Alles Wichtige aus der NWS Welt kompakt in deinem Postfach.
Wie eine Managed Cloud Ausfälle automatisch erkennt und behebt
Damit sich etwas selbst heilen kann, muss es zwei Dinge beherrschen: Es muss seinen eigenen Zustand permanent kennen und auf Abweichungen eine passende Antwort parat haben. Genau hier spielt eine Managed Cloud ihre Stärken aus, da beide Bausteine bereits eingerichtet, getestet und aufeinander abgestimmt sind.
Monitoring und Health Checks fungieren als Frühwarnsystem
Alles beginnt mit der Frage: „Geht es dir gut?” Das System stellt sie unentwegt, oft mehrmals pro Minute. Health Checks prüfen, ob ein Dienst nicht nur läuft, sondern auch wirklich arbeitet. Ein Prozess kann technisch aktiv sein und trotzdem keine einzige Anfrage mehr beantworten. Ein guter Health Check merkt den Unterschied.
Dahinter steht ein durchdachtes Monitoring, das Metriken wie CPU-Last, Speicherverbrauch, Antwortzeiten und Fehlerraten laufend beobachtet. Bei NWS setzen wir dafür auf die bewährten Open Source-Werkzeuge Icinga und Prometheus. Sie liefern nicht nur den aktuellen Zustand, sondern auch Trends. Und Trends sind Gold wert, denn ein langsam steigender Speicherverbrauch verrät einen Ausfall oft schon, bevor er passiert.
Automatische Gegenmaßnahmen: Neustart, Failover oder Skalierung
Sobald ein Health Check anschlägt, folgt die entsprechende Reaktion. Welche, hängt vom Problem ab. Der Klassiker ist der automatische Neustart. Ein Dienst hängt oder ist abgestürzt – das System startet ihn neu. In vielen Fällen ist das Problem damit erledigt, bevor es ein Nutzer überhaupt bemerkt.
Reicht das nicht, kommt Failover ins Spiel. Fällt ein ganzer Server aus, übernimmt ein bereitstehender Ersatzserver. Der Datenverkehr wird umgeleitet und die Anwendung läuft auf der neuen Hardware weiter. Deine Kunden können den Dienst weiterhin nutzen, während im Hintergrund der nächste Knoten hochgefahren wird. Und wenn nicht der Ausfall, sondern die Last das Problem ist, hilft automatische Skalierung. Steigt die Nachfrage, fährt das System zusätzliche Instanzen hoch. Sinkt die Nachfrage wieder, werden sie heruntergefahren. Das schützt vor Überlastung und spart gleichzeitig Kosten, da nur die tatsächlich genutzten Ressourcen bezahlt werden.
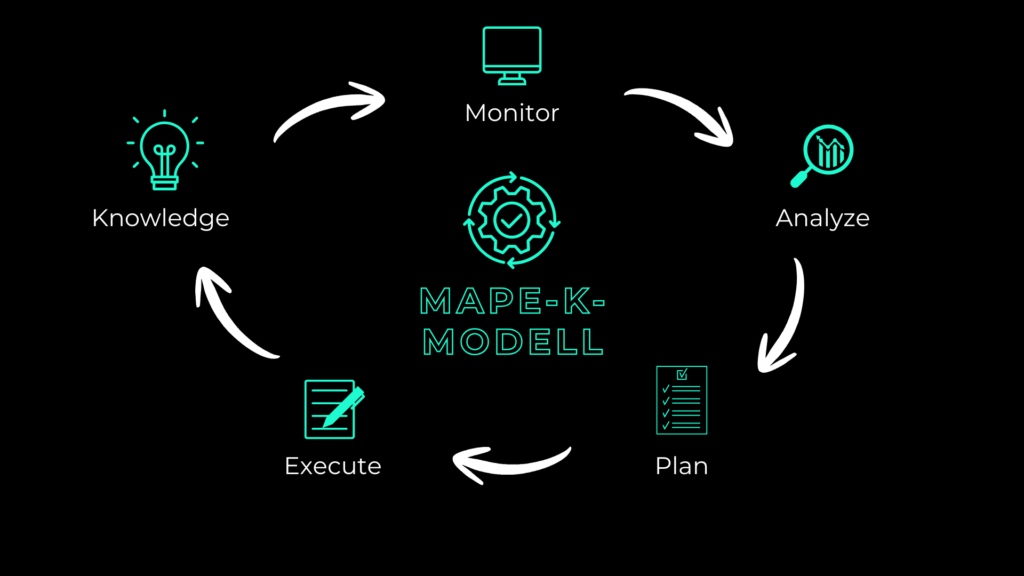
Der vierstufige Kontrollkreis (MAPE-K)
Selbstheilende Systeme arbeiten kontinuierlich nach einem festen logischen Kreislauf, der oft als MAPE-K-Modell bezeichnet wird:
- Monitor (Überwachen): Agenten und Probes sammeln permanent Telemetriedaten (Metriken, Logs, Traces) von Servern, Containern und Anwendungen.
- Analyze (Analysieren): Das System vergleicht die Echtzeitdaten mit definierten Schwellenwerten oder nutzt KI (AIOps), um Anomalien zu erkennen.
- Plan (Planen): Wird ein Problem identifiziert (z. B. ein abgestürzter Service oder Speicherknappheit), ermittelt das System die passende Gegenmaßnahme anhand von Skripten oder Playbooks.
- Execute (Ausführen): Die Korrekturmaßnahme wird automatisiert eingeleitet.
- Knowledge (Wissen): Das System greift auf eine Wissensdatenbank oder gelernte Muster zurück, um fundierte Entscheidungen zu treffen.
Typische Szenarien und automatische Lösungsansätze
In einer Managed Cloud-Umgebung greifen Self-Healing-Mechanismen bei verschiedenen Problemarten:
| Fehlertyp | Ursache | Automatische Reaktion (Self-Healing) |
| Anwendungsabsturz | Software-Bug, Memory Leak | Der betroffene Container (z.B. in Kubernetes) oder die virtuelle Maschine wird sofort neu gestartet (Restart). |
| Hardware-Defekt | Sever-Ausfall im Rechenzentrum | Die betroffenen Workloads werden per Live-Migration automatisch auf gesunde physische Server verschoben. |
| Lastspitzen | Plötzlicher hoher Besucheransturm | Auto-Scaling fährt automatisch zusätzliche Instanzen hoch und der Load Balancer verteilt den Datenverkehr neu. |
| Fehlerhaftes Update | Neue Software-Version wirft Fehler | Das System führt ein automatisches Rollback auf die letzte stabile Version durch. |
| Speicherplatzmangel | Volllaufende Festplatten / Logs | Automatische Bereinigungsskripte löschen alte Caches oder die Storage-Kapazität wird dynamisch erweitert. |
Die Rolle von Monitoring und Observability
Self-Healing ist nur mit zuverlässigen Informationen über den Zustand des Systems möglich. Monitoring und Observability sind deshalb zentrale Bestandteile einer automatisierten Cloud-Infrastruktur.
Monitoring beantwortet beispielsweise folgende Fragen:
- Ist der Service verfügbar?
- Wie hoch ist die CPU-Auslastung?
- Wie viele Fehler treten auf?
- Wie viele Requests werden verarbeitet?
Observability geht einen Schritt weiter und hilft dabei, den internen Zustand komplexer Systeme anhand von Metriken, Logs und Traces nachvollziehbar zu machen. Gerade bei Microservices ist das wichtig. Denn wenn eine Anwendung aus Dutzenden oder Hunderten Services besteht, reicht die Frage „Ist der Server online?” nicht mehr aus.
Stattdessen muss beispielsweise Folgendes erkannt werden:
User Request → Frontend → API → Service A → Service B → Database
Wenn Service B nicht reagiert, muss die Plattform den Fehler möglichst schnell erkennen und entsprechend reagieren.
Self-Healing bei Datenbanken: eine besondere Herausforderung
Ein ausgefallener Webserver kann in der Regel vergleichsweise einfach ersetzt werden. Die automatische Wiederherstellung einer Datenbank ist hingegen wesentlich anspruchsvoller. Eine Datenbank enthält Daten, deren Konsistenz erhalten bleiben muss. Deshalb reicht es nicht aus, einfach einen neuen Container zu starten. Je nach Architektur können beispielsweise folgende Mechanismen erforderlich sein: Replikation, Failover, High Availability, automatisierte Backups, Point-in-Time-Recovery, redundanter Storage, Datenbank-Cluster oder regelmäßige Restore-Tests.
Hier zeigt sich eine wichtige Grenze von Self-Healing: Ein automatisch neu gestarteter Service bedeutet nicht automatisch, dass die zugrunde liegenden Daten wiederhergestellt sind. Self-Healing muss deshalb immer im Kontext der gesamten Systemarchitektur betrachtet werden.
Self-Healing in der Praxis: das Beispiel Kubernetes
Wer über Self-Healing spricht, kommt früher oder später unweigerlich auf Kubernetes, denn dort ist der Selbstheilungsgedanke fest integriert. Kubernetes vergleicht permanent den gewünschten Zustand mit der Realität und korrigiert selbstständig, sobald beide voneinander abweichen.
Drei Mechanismen veranschaulichen dies besonders gut:
- Liveness Probes fragen: „Lebt dieser Container noch?” Wenn er nicht antwortet, wird er neu gestartet. So werden hängende Prozesse abgefangen, die technisch vorhanden sind, aber nichts mehr leisten.
- Readiness Probes fragen, ob der Container bereit ist, Anfragen zu empfangen. Solange die Antwort „Nein” lautet, bekommt er keinen Datenverkehr. So landen keine Anfragen bei einer Instanz, die noch startet oder gerade überlastet ist.
- ReplicaSets wachen über die Anzahl. Du möchtest drei Instanzen, aber es laufen nur noch zwei? Kubernetes startet ohne Nachfrage eine dritte. Fällt ein kompletter Knoten aus, verteilt der Scheduler die betroffenen Container auf gesunde Knoten.
Das Ergebnis ist eine Infrastruktur, die kleine Störungen wegsteckt, ohne dass jemand davon Notiz nimmt. Genau diese Basis bringt eine Managed-Kubernetes-Umgebung mit, ohne dass du sie selbst von Grund auf aufbauen und pflegen musst.
Self-Healing muss deshalb immer im Kontext der gesamten Systemarchitektur betrachtet werden.
Welche Vorteile bietet Self-Healing Unternehmen?
Self-Healing ist keine technische Spielerei. Automatisierte Wiederherstellung kann einen konkreten geschäftlichen Nutzen haben.
- Ausfallzeiten: Je schneller ein Fehler erkannt und behoben wird, desto geringer ist die Ausfallzeit.
- Höhere Verfügbarkeit: Redundanz und automatische Wiederherstellung können die Verfügbarkeit geschäftskritischer Anwendungen verbessern.
- Weniger Routinearbeit: IT-Teams müssen nicht jeden einzelnen Container-Neustart oder standardisierten Recovery-Prozess manuell durchführen.
- Schnellere Reaktion: Automatisierte Systeme können innerhalb von Sekunden reagieren – unabhängig davon, ob gerade ein Administrator vor dem Monitoring sitzt.
- Bessere Skalierbarkeit: Mit zunehmender Anzahl von Services wird manuelles Management immer schwieriger. Automatisierung ermöglicht den Betrieb größerer Umgebungen.
- Standardisierte Prozesse: Ein definierter Fehlerzustand kann immer nach denselben Regeln behandelt werden.
Self-Healing vs. klassischer IT-Betrieb
Der Unterschied lässt sich vereinfacht darstellen:
| Klassischer Betrieb | Self-Healing Cloud |
| Fehler tritt auf | Fehler tritt auf |
| Monitoring meldet Problem | Monitoring erkennt Problem |
| Administrator analysiert | Automatisierung bewertet Zustand |
| Manueller Neustart | Automatisierte Recovery |
| Administrator prüft System | Health Check prüft System |
| Betrieb wird wiederhergestellt | Betrieb wird automatisch wiederhergestellt |
| Nachträgliche Analyse | Analyse kann parallel erfolgen |
Natürlich verschwimmt diese Trennung in der Praxis. Auch moderne Self-Healing-Systeme benötigen Menschen, insbesondere bei komplexen oder unbekannten Fehlern. Der Unterschied besteht vor allem darin, wie viele standardisierte Probleme automatisch behandelt werden können.
Was Self-Healing nicht leisten kann
So leistungsfähig automatisierte Recovery-Mechanismen auch sind: Self-Healing ist kein universeller Problemlöser. Es gibt zahlreiche Situationen, in denen eine menschliche Analyse weiterhin notwendig ist.
- Fehlerhafte Software: Wenn ein Programm aufgrund eines Bugs falsche Daten verarbeitet, hilft ein Neustart möglicherweise nicht. Der Fehler tritt anschließend erneut auf.
- Falsche Konfiguration: Eine fehlerhafte Konfiguration kann dazu führen, dass ein Service immer wieder ausfällt. Auch hier kann Self-Healing lediglich das Symptom behandeln.
- Datenfehler: Beschädigte oder inkonsistente Daten lassen sich nicht grundsätzlich durch einen Container-Neustart beheben.
- Sicherheitsvorfälle: Bei einem Security Incident kann ein automatisierter Neustart sogar zu kurz greifen. Hier sind Analyse, Isolation und gezielte Maßnahmen erforderlich.
- Kaskadierende Fehler: Wenn mehrere voneinander abhängige Services gleichzeitig ausfallen, reicht eine einfache Recovery-Logik möglicherweise nicht aus.
- Falsche Automatisierung: Eine schlecht konfigurierte Automatisierung kann Probleme sogar verschärfen.
Deshalb müssen Recovery-Mechanismen sorgfältig getestet und überwacht werden. Self-Healing benötigt einen definierten Soll-Zustand. Ein besonders wichtiger Aspekt von Self-Healing ist die Definition dessen, was überhaupt als normaler Zustand gilt. Ohne einen definierten Soll-Zustand kann ein System nicht zuverlässig feststellen, ob eine Abweichung vorliegt.
Bei Kubernetes könnte dieser Soll-Zustand beispielsweise wie folgt definiert sein: replicas: 3. Damit ist vereinfacht gesagt definiert: „Drei Instanzen sollen verfügbar sein.” Die Plattform vergleicht kontinuierlich den gewünschten mit dem tatsächlichen Zustand. Genau dieses Desired-State-Modell ist ein fundamentaler Bestandteil moderner Cloud-Native-Architekturen.
Die Voraussetzungen für funktionierendes Self-Healing
Self-Healing entsteht nicht automatisch, nur weil eine Anwendung in die Cloud verschoben wird. Es bedarf einer entsprechenden technischen Grundlage.
- Redundanz: Eine Anwendung kann nur dann automatisch auf eine andere Instanz ausweichen, wenn entsprechende Ressourcen vorhanden sind.
- Monitoring: Das System muss erkennen können, wann ein Fehler auftritt.
- Health Checks: Es muss definiert sein, was „gesund” beziehungsweise „funktionsfähig” bedeutet.
- Automatisierung: Es müssen konkrete Aktionen definiert werden, die auf bestimmte Fehlerzustände reagieren.
- Hochverfügbarkeit: Kritische Komponenten sollten redundant ausgelegt sein.
- Gute Architektur: Stateless Services eignen sich häufig besser für die automatisierte Wiederherstellung als stark gekoppelte monolithische Systeme.
- Backup und Recovery: Self-Healing ersetzt keine Backups.
- Observability: Bei komplexen Systemen müssen Ursachen und Abhängigkeiten nachvollziehbar bleiben.
Self-Healing richtig planen: Worauf Unternehmen achten sollten
Wer Self-Healing in einer Managed Cloud etablieren möchte, sollte nicht einfach möglichst viele automatische Aktionen aktivieren. Stattdessen empfiehlt sich ein strukturiertes Vorgehen.
Schritt 1: Kritische Services identifizieren:
Welche Anwendungen müssen besonders hoch verfügbar sein?
Schritt 2: Fehlerzustände definieren:
Welche Zustände können automatisch erkannt werden?
Schritt 3: Recovery-Maßnahmen festlegen:
Welche Reaktion ist bei welchem Fehler sinnvoll?
Schritt 4: Health Checks implementieren:
Wie lässt sich zuverlässig feststellen, ob eine Anwendung funktioniert?
Schritt 5: Monitoring und Alerting aufbauen:
Welche Metriken und Ereignisse müssen überwacht werden?
Schritt 6: Automatisierung testen:
Was passiert tatsächlich, wenn ein Pod, Node oder Service ausfällt?
Schritt 7: Failover regelmäßig testen:
Ein Self-Healing-System sollte nicht nur theoretisch funktionieren. Recovery-Szenarien müssen regelmäßig getestet werden.
Schritt 8: Eskalationswege definieren:
Was passiert, wenn die automatische Wiederherstellung scheitert?
Chaos Engineering: Self-Healing gezielt testen
Eine interessante Methode, um die Widerstandsfähigkeit einer Cloud-Umgebung zu testen, ist das Chaos Engineering. Dabei werden kontrolliert Fehler erzeugt.
Beispielsweise kann Folgendes getestet werden:
- Was passiert, wenn ein Pod ausfällt?
- Was passiert bei einem Node-Ausfall?
- Wie reagiert die Anwendung auf Netzwerkprobleme?
- Wie verhält sich das System bei hoher Last?
- Wie schnell funktioniert ein Failover?
Das Ziel besteht nicht darin, Systeme absichtlich zu beschädigen, sondern herauszufinden, wie gut sie mit Störungen umgehen können. Gerade für Self-Healing ist das besonders relevant. Denn ein automatisierter Recovery-Prozess ist nur dann wertvoll, wenn er auch unter realistischen Bedingungen zuverlässig funktioniert.
Wo Automatisierung endet und menschliche Interaktion anfängt
Self-Healing ist zwar mächtig, aber kein Allheilmittel. Die automatische Selbstheilung ist hervorragend im Umgang mit dem Bekannten. Ein abgestürzter Prozess, ein ausgefallener Knoten oder eine Lastspitze sind alles Muster, für die es klare Reaktionen gibt. Schwieriger wird es beim Unerwarteten. Ein fehlerhaftes Deployment etwa, das brav durch alle Health Checks kommt, aber trotzdem falsche Daten ausliefert. Eine schleichende Fehlkonfiguration. Oder ein Angriff, der sich als normaler Traffic tarnt. Solche Fälle kann kein Automatismus vollständig abfangen, da sie sich nicht in eine einfache Wenn-dann-Regel pressen lassen. Und manchmal reagiert die Automatisierung sogar zu gut. Ein Dienst, der alle 30 Sekunden neu startet, weil die eigentliche Ursache tiefer liegt, verdeckt das Problem, statt es zu lösen. Hier ist jemand gefragt, der hinschaut, die Ursache findet und die Regeln anpasst.
Deshalb kombinieren wir bei NWS beides. Die Automatisierung übernimmt die schnellen, wiederkehrenden Reaktionen. Unsere Engineers kümmern sich um alles, was Urteilsvermögen erfordert. Mit MyEngineer® bekommst du einen echten Menschen an die Seite, der deine Umgebung kennt, statt einer Hotline, die dich bei jedem Anruf neu kennenlernen muss. Dank Self-Healing bleiben die meisten Nächte ruhig. Und wenn es doch einmal ernst wird, ist jemand da, der versteht, was passiert.
Fazit: Self-Healing macht Cloud-Infrastrukturen widerstandsfähiger
Self-Healing-Systeme sind ein wichtiger Bestandteil moderner Cloud-Native-Architekturen. Sie ermöglichen die automatische Erkennung bestimmter Fehler und die Einleitung definierter Recovery-Maßnahmen. Kubernetes veranschaulicht dieses Prinzip besonders deutlich: Anstatt lediglich auf Fehler zu reagieren, wird ein gewünschter Zustand definiert und kontinuierlich aufrechterhalten. Doch Self-Healing bedeutet nicht, dass eine Infrastruktur vollkommen autonom arbeitet. Komplexe Fehler, Datenprobleme, Sicherheitsvorfälle oder grundlegende Architekturfehler benötigen weiterhin menschliche Expertise. Die eigentliche Stärke liegt deshalb in der Kombination: Automatisierung übernimmt wiederkehrende Aufgaben, während sich Experten um die komplexen Probleme kümmern.
Für Unternehmen bedeutet das: weniger manuelle Routinearbeit, schnellere Reaktionen auf bestimmte Ausfälle und eine belastbarere Infrastruktur. Eine moderne Managed Cloud kann bei richtiger Einrichtung zu einer automatisierten, überwachten und resilienten Plattform werden, die viele Probleme erkennt und behebt, bevor daraus ein größerer Ausfall entsteht.

0 Kommentare